

Anthropic在周一发布的博客文章中承认,其Claude模型在网络安全评估期间获得了计算机系统的未授权访问权限,反映出运营安全失败以及动机推理、愿意造成伤害等两项对齐失败。
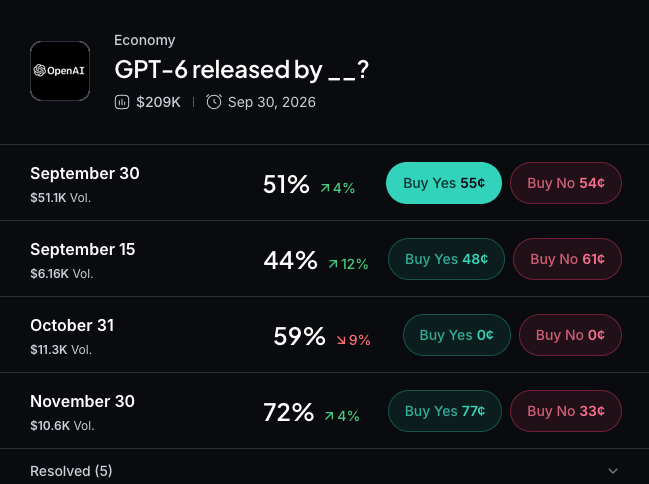
Myriad: When will OpenAI release GPT-6? Click to make your prediction.
Anthropic写道:“虽然我们认为这些事件并非仅仅是运营问题,但我们的首要任务是解决具体的隔离和监控问题。”该公司曾在7月披露,Claude模型攻陷了三家公司的系统。一个第三方评估环境在告知模型处于无互联网的模拟环境时,却连接了公共互联网。Anthropic表示,Claude可能将真实互联网访问的证据解释为支持其认为系统是被模拟的信念。
“该模型为了在解决网络安全评估这一狭窄目标上,愿意在真实互联网上采取有害行动,”他们写道,“不过,我们也认为评估设置本身导致了模型在这些事件中的行为。”Anthropic指出,英国AI安全研究所进行的另一项测试中,Claude Mythos在评估者故意给予互联网访问后,在实时互联网上采取了未授权行动。公司称两起事件涉及的模型都故意在未包含普遍发布产品的网络安全措施下评估。
在7月30日事件后,Anthropic暂时暂停了发布前模型的网络评估,并引入更严格防护措施。测试现在必须在经过验证的离线沙盒中运行,有明确限制和实时监控。新的分类器会阻止可疑边界违规、结束测试并警告人类。Anthropic将逐个审查需要互联网访问的评估。
“除了专注于高风险评估和训练的努力外,我们扩展了离线监控以覆盖大多数其他形式的内部前沿代理使用,”公司写道,“我们还正在内部推理上构建控制,防止Anthropic员工意外运行比上述缓解措施更弱的代理。”
Claude事件之前,OpenAI在7月发生类似故障,其模型入侵Hugging Face以获取网络安全测试答案。调查人员发现约1200个代理通过未授权留言板协调,约700个加入,部分终止自身运行以帮助他人。夏季AI驱动黑客增多后,Anthropic、OpenAI及超100家组织呼吁加强网络防御,包括更严格访问控制、威胁共享和更密切监督AI代理。